1. RPO i RTO: konkretne cele zamiast „szybkiego backupu”
RPO (Recovery Point Objective) określa, ile danych firma może maksymalnie utracić w czasie — w praktyce: do jakiego punktu wstecz musi sięgać możliwy do odtworzenia backup. RPO 24 godziny oznacza, że po awarii firma może stracić nawet cały dzień zmian. RTO (Recovery Time Objective) określa maksymalny akceptowany czas przywrócenia procesu lub systemu do działania. To nie tylko czas kopiowania plików: wlicz konfigurację sprzętu, systemu, aplikacji, kont, testów i decyzji biznesowej o powrocie do pracy.
RPO i RTO powinien zatwierdzić właściciel procesu, bo niższe wartości zwykle oznaczają częstsze kopie, większą retencję, replikację i dodatkowe koszty. IT może oszacować wykonalność, ale nie powinno samo zgadywać, czy firma wytrzyma pół dnia bez systemu sprzedaży albo utratę ostatnich czterech godzin zamówień.
| Proces | Pytanie o RPO | Pytanie o RTO |
|---|---|---|
| Faktury / księgowość | Ile wprowadzonych dokumentów można odtworzyć z innych źródeł? | Kiedy księgowość musi znów wystawiać i księgować dokumenty? |
| System rezerwacji / PMS | Jakie rezerwacje i zmiany trzeba odzyskać po utracie bazy? | Jak długo hotel może prowadzić meldunki awaryjnie ręcznie? |
| Pliki zespołu / NAS | Jak często powstają ważne zmiany projektów i ofert? | Czy można pracować tymczasowo z kopii albo innego urządzenia? |
| System produkcyjny / ERP | Jak często zmieniają się transakcje i dane podstawowe? | Jakie procesy zatrzymują się bez ERP i jaki jest koszt godziny? |
2. Jak ustalić priorytety odzyskiwania?
Nie odzyskuje się wszystkiego jednocześnie. Spisz zależności: internet i DNS, tożsamość, serwer plików, baza, aplikacja, integracja z bankiem lub PMS, drukarki i urządzenia końcowe. Jeżeli baza jest dostępna, ale nikt nie może zalogować się do niej albo klucz szyfrujący zginął, usługa nadal nie działa. Dla każdego procesu ustal:
- kto jest właścicielem biznesowym i kto zatwierdza powrót do pracy;
- gdzie znajduje się produkcja oraz niezależna kopia;
- jakie konta, licencje, klucze, konfiguracje i sprzęt są potrzebne;
- kolejność odtworzenia oraz sposób bezpiecznej walidacji danych;
- tymczasowy proces ręczny i komunikację z pracownikami/klientami.
NIST definiuje RPO jako punkt w czasie, do którego dane muszą być odtworzone, a RTO jako cel czasu przywrócenia. Wartości wpisz do planu, a potem porównaj je z faktycznym wynikiem testu — nie z deklaracją producenta backupu.
3. 3-2-1, kopia offline i niezmienność
Reguła 3-2-1 to użyteczny punkt wyjścia: trzy kopie danych, na co najmniej dwóch rodzajach nośnika lub niezależnych systemach, z jedną kopią poza podstawową lokalizacją. Dla odporności na ransomware sama lokalizacja „w chmurze” nie wystarczy: konto backupu nie może być stale osiągalne i zarządzane tymi samymi poświadczeniami co domena produkcyjna.
- Odseparuj administrację: osobne konto i MFA do panelu backupu, minimalne uprawnienia, zakaz używania codziennego konta administratora jako konta serwisowego.
- Zabezpiecz kopię przed zmianą: rozważ offline, WORM/immutability lub blokadę retencji, jeśli wspiera to platforma, storage i licencja. Sprawdź, kto może wyłączyć ochronę i jak działa okres blokady.
- Nie trzymaj jedynej kopii obok produkcji: NAS w tej samej szafie może pomóc po awarii dysku serwera, ale nie zabezpieczy przed kradzieżą, pożarem, zalaniem, wspólnym kontem administratora ani szyfrowaniem obu urządzeń.
- Chroń także konfiguracje: firewall, przełączniki, Wi-Fi, hypervisor, domenę, certyfikaty, klucze, ustawienia backupu i dokumentację odtworzenia.
- Kontroluj retencję i pojemność: zadanie, które wypadło z harmonogramu przez brak miejsca, nie tworzy kopii — monitoruj alerty i okresowo sprawdzaj raporty.
CISA zaleca małym firmom m.in. automatyczne kopie krytycznych danych, MFA, aktualizacje oraz szyfrowanie danych. Nie istnieje jednak jeden schemat 3-2-1, który automatycznie spełni każde RPO/RTO. Częstotliwość, retencja, typ kopii i odzyskanie aplikacji muszą wynikać z analizy procesów.
4. Jak przeprowadzić test odtworzenia?
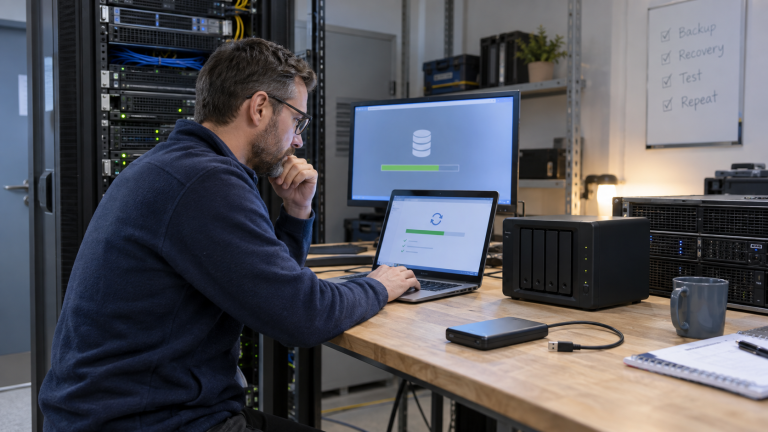
Test musi sprawdzić odtworzenie, nie tylko to, że plik backupu da się pobrać. Zacznij od kopii pojedynczego pliku i skrzynki testowej, następnie wykonaj odtworzenie maszyny wirtualnej lub bazy do odizolowanej sieci, a później przeprowadź ćwiczenie całej krytycznej usługi. Nie nadpisuj środowiska produkcyjnego podczas pierwszego testu.
- Wybierz scenariusz i cel: np. przypadkowe skasowanie folderu, awaria dysku hosta, utrata NAS-a albo zaszyfrowanie serwera.
- Wskaż punkt odtworzenia: zapisz datę kopii i maksymalną utratę danych, czyli zmierzony RPO.
- Uruchom kopię poza produkcją: użyj izolowanego hosta/sieci, aby nie uruchomić równoległej domeny, adresów IP czy zadań produkcyjnych.
- Zweryfikuj aplikację: logowanie testowego użytkownika, otwieranie rekordów, zgodność bazy, działanie druków i integracji. Sam ping lub start VM nie oznacza, że proces biznesowy działa.
- Zapisz czasy: od decyzji o odtworzeniu do gotowej usługi; to zmierzony RTO. Oddziel czas oczekiwania na decyzję i dostarczenie sprzętu od czasu samego transferu.
- Usuń testowe dane i popraw plan: opisz problem, właściciela, termin i powtórz test po naprawie.
Nie wszystkie kopie muszą być testowane jednakowo często. Częstotliwość powinna rosnąć wraz z wpływem awarii i zmianami systemu. Po migracji serwera, wymianie NAS-a, zmianie kluczy szyfrujących lub istotnej zmianie retencji wykonaj test ponownie. Co najmniej jedna osoba poza głównym administratorem powinna znać procedurę i lokalizację instrukcji.
5. Odtwarzanie po awarii, ransomware i błędzie człowieka
Przy ransomware nie przywracaj pośpiesznie serwera do tej samej płaskiej sieci, zanim nie rozpoznasz zakresu incydentu i nie zabezpieczysz czystego środowiska. Najpierw ogranicz rozprzestrzenianie, zabezpiecz logi i zidentyfikuj czyste kopie. Zmień poświadczenia uprzywilejowane z bezpiecznej stacji, sprawdź kopie offline/immutable, a przywracaną usługę trzymaj w izolacji do czasu walidacji. Procedura konkretnego incydentu powinna wskazywać osoby decyzyjne, komunikację i kontakt z dostawcą IT/bezpieczeństwa.
Przy awarii sprzętu lub pomyłce użytkownika dobierz punkt odtworzenia do zakresu: pojedynczy plik, baza aplikacji, cały serwer albo infrastruktura. Warto zachować kilka punktów odtworzenia i historię wersji, bo najnowsza kopia może już zawierać uszkodzenie lub zaszyfrowane pliki. Snapshot NAS-a jest szybkim punktem powrotu, ale sam nie zastępuje niezależnego backupu — snapshot może być usunięty przez administratora albo awarię tego samego urządzenia.
6. Przykładowy plan i checklista testów
| System | Właściciel | RPO zatwierdzone | RTO zatwierdzone | Ostatni test |
|---|---|---|---|---|
| Tożsamość / katalog | IT + manager | Do określenia | Do określenia | Data, czas, wynik |
| ERP / PMS / aplikacja krytyczna | Właściciel procesu | Do określenia | Do określenia | Data, scenariusz, wynik |
| Pliki firmowe / NAS | IT + właściciel danych | Do określenia | Do określenia | Data, próbka danych |
| Sieć i konfiguracje | IT | Po każdej zmianie | Do określenia | Data, eksport konfiguracji |
- □ Co najmniej jedno odtworzenie pliku sprawdza kompletność i czytelność danych.
- □ Kopia systemu krytycznego uruchamia się w środowisku testowym i przechodzi test funkcjonalny.
- □ Administrator może znaleźć hasła awaryjne, licencje, klucze i instrukcję bez dostępu do produkcyjnego konta pracownika.
- □ Odtworzenie nie wymaga tych samych kont/urządzeń, które mogły zostać przejęte w incydencie.
- □ Zapisano zmierzone RPO/RTO, odchylenia, problemy i zatwierdzenie właściciela procesu.
- □ Po zmianie konfiguracji wykonano nowy backup oraz zaplanowano kolejny test.
7. Typowe pułapki backupu
- Traktowanie snapshotu na NAS-ie jako jedynej kopii.
- Raportowanie „zadanie OK” bez sprawdzenia, czy da się otworzyć odzyskane pliki i uruchomić aplikację.
- Jedno konto administratora zarządza produkcją, kopiami i chmurą.
- Retencja kopii jest krótsza niż czas, w którym firma może zauważyć uszkodzenie lub włamanie.
- Brak kopii konfiguracji firewalli, kontrolerów, licencji i dokumentacji.
- Nieustalone RPO/RTO — przez co awaria staje się pierwszym ćwiczeniem odzyskiwania.
Szersze porównanie NAS-a, chmury, Veeam, Synology i QNAP znajdziesz w naszym przewodniku po backupie w firmie. Jeśli potrzebujesz uporządkować harmonogramy, retencję, odtworzenia i odpowiedzialność za kopie, sprawdź nasze usługi IT lub skontaktuj się z IT Node.
Źródła i dalsza dokumentacja
- CISA: zasoby cyberbezpieczeństwa dla małych i średnich firm
- NIST SP 800-34 Rev. 1: Contingency Planning Guide
RPO i RTO są celami biznesowymi, a rzeczywisty wynik zależy od danych, sprzętu, licencji, sieci, personelu i zakresu awarii. Powyższe scenariusze są punktem do przygotowania i testowania planu konkretnej firmy, nie gwarancją określonego czasu odzyskania.